有时候想找首歌的纯伴奏练唱,或者做翻唱、剪辑时想单独留一段人声,搜来搜去不是音质一般,就是要先把音频传到网页上。最近整理音频工具时,我觉得 Ultimate Vocal Remover(UVR)挺值得一提:它是一个用 AI 模型做音源分离的桌面软件,能把混在一起的人声和伴奏拆开,适合喜欢折腾音乐素材的朋友 🎧
它不是那种“点一下就保证变成录音棚母带”的魔法按钮,不过作为免费开源的分离工具,能自己选模型、在电脑上处理音频,确实给了人不少空间。
它能帮你做什么?
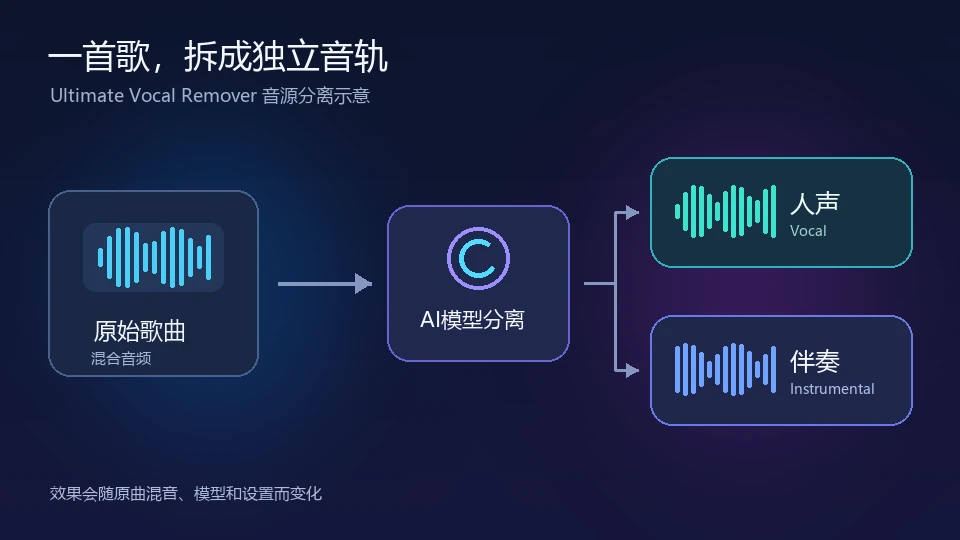
最常用的就是把一首歌分成人声和伴奏:想跟唱、练习编曲时,可以先拿伴奏;想听清旋律或做翻唱参考,也能单独导出人声。UVR 还兼容多种分离模型;部分模型可以把音乐进一步拆成鼓、贝斯、人声等音轨,适合做采样、混音和二次创作。
我觉得它比较实用的地方
- 解决“找不到伴奏”的小麻烦:手边只有一份混音成品时,可以试着提取伴奏,练歌或做个人练习会方便不少。
- 模型可以挑:UVR 5.6 官方版本兼容 Demucs v1 到 v4,也支持 MDX23C;不同模型的取舍不一样,遇到难分的歌曲时换一个模型试试,结果可能会更合适。
- 桌面处理更顺手:选好音频、模型和输出位置后就能开始跑,不需要每次都把文件上传到在线分离网站。第一次下载程序或模型时仍需要网络。
效果怎么样?先说点实在的
普通流行歌曲通常比较容易听出分离结果,但如果原曲混响很重、合唱和乐器频段挤在一起,导出的音轨可能会留一点“水声”、毛边或残响。不同模型听感也会有差异,我自己的建议是先用默认参数跑一遍,再拿同一小段音频换模型对比,别一上来就为了参数纠结半天 🙂
另外,AI 分离不能把已经混在一起的声音百分之百还原成原始录音轨。若是要做严肃混音,最好把结果当作素材起点,耳朵听着不满意就再试别的模型。
适合哪些人试试?
平时唱歌练习、做翻唱、剪视频需要提取人声片段,或者刚入门想玩玩音源分离的朋友,都可以把 UVR 放进工具箱。它的模型和设置选项比较多,对完全没接触过音频软件的人来说,第一次打开可能会有点眼花;但先从“导入歌曲—选人声/伴奏分离模型—开始处理”这条路线走,基本就能摸到门道。
软件的处理速度会受电脑硬件和所选模型影响,模型本身也比较吃算力;如果电脑比较老,长音频就耐心等一等。Windows 安装包面向 Windows 10 及以上版本。
本站所有资源均经过测试,完全放心使用💯